
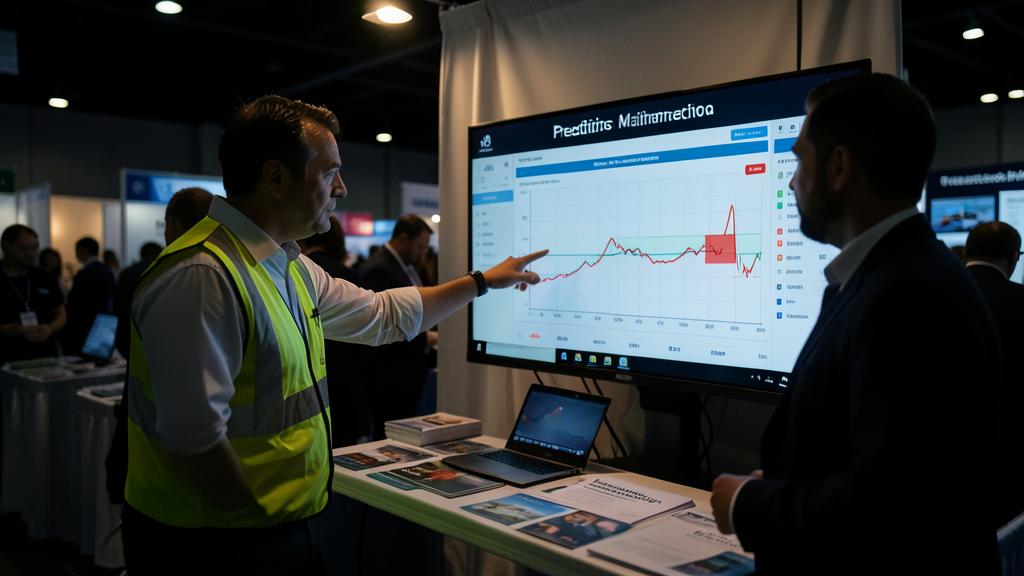
Chaque salon professionnel présente la même diapositive : une trace de vibration, un marqueur rouge deux semaines avant la dépose, une légende indiquant que la panne a été prédite. Personne dans la salle ne conteste, car il n’y a rien à contester — l’événement est réel et l’algorithme l’a bien signalé. La diapositive répond simplement à une question qu’aucun organisme de maintenance ne se pose : savoir si la panne pouvait être détectée dans des données déjà existantes. Les questions auxquelles l’exploitant doit réellement répondre sont : ce que le même détecteur émet pendant les milliers de semaines-avion où tout allait bien, qui est autorisé à lire les données dont il se nourrit, et ce que tout cela est autorisé à modifier dans le programme de maintenance approuvé.
La démonstration est la partie la plus simple du problème
Une démonstration rétrospective est construite à rebours. L’événement est connu, l’aéronef est connu, le paramètre qui a varié est connu, et le détecteur est ajusté jusqu’à ce que le marqueur se place là où l’histoire le nécessite. Rien de cela n’est malhonnête — c’est ainsi qu’une caractéristique est trouvée en premier lieu. Cela n’a cependant aucune valeur comme preuve de la valeur opérationnelle, car chaque choix de la chaîne a été fait avec une connaissance que l’atelier ne possédera pas le matin où l’alerte arrive.
Deux mécanismes méritent d’être nommés, car ils persistent jusque dans des travaux de validation d’apparence sérieuse. Le premier est la sélection : l’échantillon est tiré d’aéronefs ayant subi une panne, donc le détecteur n’est jamais confronté qu’à la moitié facile de la question. Le second est la fuite, où l’information sur le résultat s’infiltre dans les entrées — un paramètre qui n’existe que parce qu’une tâche de dépannage a déjà été ouverte, une fenêtre de données qui s’étend discrètement au-delà de la dépose, un seuil fixé après avoir regardé l’ensemble de test. La fuite gonfle les performances apparentes sans que personne ne l’ait voulu, et elle est invisible dans une salle de conférence.
La version honnête de la démonstration est terne et bien plus coûteuse à produire : faire tourner le détecteur en conditions réelles, sans regarder en arrière, sur une flotte qu’il n’a jamais vue, sur une période suffisamment longue pour contenir à la fois les pannes et le nombre bien plus grand de non-pannes, et compter tout ce qu’il a dit. C’est la seule mesure qui prédit ce que l’atelier recevra.
Les démonstrations de maintenance prédictive montrent souvent des cas où la panne a été détectée, mais elles ne disent pas combien de fausses alertes ont été émises. Pour savoir si un système est vraiment utile, il faut voir combien d’alertes sont vraies sur une longue période, pas seulement sur quelques exemples.
Un détecteur testé sur 100 avions avec 20 pannes annuelles émet 259 fausses alertes si son taux de fausses alertes est de 5 %, contre seulement 18 si ce taux est de 0,35 %. Dans le premier cas, seulement 6 % des alertes sont réelles, contre 50 % dans le second.
Les taux de base déterminent ce que l’atelier reçoit réellement
La raison pour laquelle un bon détecteur peut encore submerger un hangar n’a rien à voir avec la qualité du modèle. C’est une question d’arithmétique, et cela dépend de la rareté de la panne. Prenons une flotte de cent aéronefs, un mode de défaillance qui se produit vingt fois par an, et un détecteur évalué une fois par semaine par aéronef. Cela donne 5 200 occasions de se prononcer, dont vingt sont réelles.
| Quantité | Détecteur A | Détecteur B |
|---|---|---|
| Occasions par an (100 aéronefs, hebdomadaire) | 5 200 | 5 200 |
| Événements réels sur la période | 20 | 20 |
| Sensibilité (événements réels détectés) | 90 % — 18 détectés | 90 % — 18 détectés |
| Taux de fausses alertes sur les non-événements | 5 % | 0,35 % |
| Fausses alertes produites | 259 | 18 |
| Part des alertes qui sont réelles | environ 6 % | environ 50 % |
| Investigations par découverte réelle | environ 15 | 2 |
Les deux détecteurs détectent neuf pannes sur dix. Les documents marketing décrivent les deux comme ayant une précision de 90 %. L’un d’eux demande à l’atelier d’ouvrir quinze investigations pour trouver un défaut ; l’autre en demande deux. La différence entre eux n’est pas la sensibilité, ce que les démonstrations montrent, mais le taux de fausses alertes sur la population énorme d’aéronefs sains, que les démonstrations ne montrent presque jamais car il faut pour cela la moitié ennuyeuse du jeu de données.
C’est pourquoi la question utile sur un stand n’est jamais détecte-t-il. C’est : sur quelle période, sur combien d’aéronefs, combien d’alertes a-t-il émises au total, et combien de celles-ci se sont conclues par une découverte confirmée. Si la réponse est un pourcentage plutôt que deux décomptes, cela n’a pas été mesuré en service.
Le piège. Un détecteur cité à 95 % de précision sur un événement rare est généralement pire qu’inutile : un modèle qui dit tout va bien à chaque fois aurait un score supérieur à 99 % sur la même flotte. La précision est sans signification lorsque les classes sont déséquilibrées. Demandez le nombre d’alertes et les découvertes confirmées, jamais un seul pourcentage de synthèse.
Une alerte n’est utile que dans une fenêtre de planification
Une prédiction qui arrive quatre jours avant la panne est un AOG avec de la paperasse en plus. Une prédiction qui arrive quatre mois trop tôt fait déposer une pièce qui avait encore du potentiel, ce qui est exactement le gaspillage que la maintenance conditionnelle devait éliminer. La valeur d’une prédiction se situe dans une fenêtre de planification délimitée d’un côté par le temps nécessaire pour obtenir la pièce, un créneau, une équipe qualifiée et, le cas échéant, l’accord de l’autorité, et de l’autre par le point où agir tôt coûte plus que l’événement non planifié l’aurait fait.
Cette fenêtre n’est pas une propriété de l’algorithme. C’est une propriété de l’exploitant : politique de rechanges, structure du réseau, passage ou non de la nuit dans une escale dotée de moyens de maintenance, délais de réparation contractuels, horizon de gel du plan de maintenance. La même fenêtre d’alerte qui est confortable pour une flotte long-courrier basée sur un hub est inutile pour un exploitant régional dont les avions ne passent par une escale équipée qu’une fois toutes les deux semaines. Un fournisseur qui ne peut pas exprimer la distribution des délais d’anticipation de ses alertes — pas la moyenne, la dispersion — n’a pas réfléchi à la contrainte du client.
La question miroir est la vitesse de dégradation. Certains modes de panne progressent suffisamment lentement et de manière prévisible pour qu’une tendance ait un sens ; d’autres sont dominés par un événement initiateur aléatoire, et aucun historique, si long soit-il, ne permet de les prédire. Décider à quelle catégorie appartient un mode de panne donné relève de l’ingénierie de la fiabilité, pas de la science des données, et c’est l’étape la plus souvent sautée.
Ce qu’une alerte est autorisée à changer
C’est là que l’enthousiasme rencontre les documents approuvés. Le programme de maintenance d’un exploitant est un document approuvé. Dans le cadre européen, les tâches et intervalles découlent des données de planification de maintenance du constructeur, elles-mêmes élaborées par l’analyse industrielle MSG-3 et consolidées par le Maintenance Review Board, et le programme de l’exploitant est approuvé par, ou selon une procédure convenue avec, l’autorité compétente. Un algorithme de fournisseur reste en dehors de cette chaîne tant que personne ne l’y intègre.
En pratique, une alerte peut occuper l’une de plusieurs positions très différentes, et le contrat doit préciser laquelle :
- Purement consultative. L’alerte produit une notification interne d’ingénierie. Aucune tâche approuvée ne bouge, aucun intervalle ne change, et l’avion reste en état de navigabilité selon le programme existant. C’est là que presque chaque déploiement commence, et il n’y a rien de mal à y rester.
- Déclencheur pour une tâche existante. L’alerte provoque la réalisation d’une inspection ou d’un contrôle fonctionnel déjà approuvé, plus tôt que l’intervalle ne le nécessiterait. Rien de nouveau n’est inventé ; seul le moment change. Simple, et la documentation existe déjà.
- Crédit au sein du programme. La surveillance remplace ou prolonge une tâche programmée. Cela modifie le programme approuvé et nécessite les données du constructeur et l’accord de l’autorité. C’est aussi le seul cas où le système prédictif réduit réellement les coûts du programme plutôt que d’ajouter une charge d’investigation.
- Imposé par la navigabilité. Lorsqu’une tâche existe parce qu’une directive de navigabilité ou une exigence de maintenance liée à la certification (CMR) l’exige, la surveillance ne la remplace pas sur la base de la confiance d’un fournisseur.
La distinction a une importance commerciale. Un système dans les deux premières positions est un outil de productivité dont le bénéfice se mesure en perturbations évitées. Seul le troisième réduit le travail programmé, et seul le troisième nécessite un dossier réglementaire — que le fournisseur peut ou non être prêt à construire, et qui fait rarement partie du prix indiqué sur le stand.
Le bon réflexe. Avant de discuter du prix, notez quelle position parmi les quatre ci-dessus l’alerte occupera dans votre organisation dès le premier jour, et qui, au sein de la CAMO, signe lorsqu’elle se déclenche. Si personne ne peut nommer cette personne, le projet pilote se terminera par une boîte mail que personne ne lit.
L’accès aux données est une question contractuelle, pas technique
La maintenance prédictive repose sur des données qui existent déjà et qui ont déjà des propriétaires, des dépositaires et des contraintes légales. Données de vol enregistrées, paramètres de surveillance de l’état, messages de maintenance transmis, entrées du journal technique, historiques de dépose de composants, constats d’atelier : chacune a une origine différente et un ensemble différent de règles associées. Les regrouper dans une plateforme de fournisseur est un transfert de quelque chose de précieux, et cela mérite le même examen qu’un accord sur les pièces de rechange.
| Question | Pourquoi cela décide du résultat | Où cela doit être réglé |
|---|---|---|
| Quels paramètres quittent l’aéronef, à quelle fréquence, et par quelle liaison | Détermine ce que le modèle pourra jamais voir, et le coût de transmission récurrent | Annexe technique, avec le périmètre figé |
| Qui peut lire les données brutes par opposition aux indicateurs dérivés | Les données enregistrées brutes peuvent identifier un équipage et un vol spécifique ; les indicateurs généralement non | Clause de protection des données et politique de données de vol de l’exploitant |
| Si le fournisseur peut réutiliser les données de la flotte pour améliorer les modèles vendus à d’autres | Courant, souvent passé sous silence, et parfois acceptable — mais cela devrait être une décision | Clause de licence et de réutilisation |
| Ce qui revient si le contrat prend fin | Sans portabilité, cinq ans d’historique restent avec le fournisseur et l’exploitant repart de zéro | Clause de sortie, avec format et délai |
| Périodes de conservation et suppression | À aligner sur les règles de conservation de l’exploitant et ses obligations légales | Calendrier de conservation |
| Si la logique d’alerte peut être auditée ou est une boîte noire | Détermine si l’on pourra un jour présenter à l’autorité un dossier de crédit | Clause de transparence |
La question de l’identification des équipages mérite d’être souligné. Lorsque l’exploitant met en œuvre un programme d’analyse des données de vol, sa légitimité entière — dans le cadre de l’OACI et du système de gestion de la sécurité de l’exploitant — repose sur une utilisation non punitive et une désidentification maîtrisée. Acheminer les mêmes données dans une plateforme d’analyse de maintenance avec une population d’utilisateurs différente et un contrat différent peut rompre silencieusement les protections qui ont rendu le programme acceptable aux yeux des navigants à l’origine. C’est une conversation à avoir avec le département sécurité et les représentants des navigants avant le projet pilote, pas après que quelqu’un s’en est aperçu.
L’incitation que personne ne met sur une diapositive
Demandez qui paie pour une fausse alerte. Dans de nombreux contrats, la réponse est l’exploitant : le travail d’investigation, la dépose, la visite en atelier, la pièce de prêt, la perturbation de l’horaire. Le fournisseur, lui, n’expose que sa réputation. Cette asymétrie pousse le seuil dans une direction — vers la sensibilité, car une panne manquée est visible et blâmée, tandis que cent fausses alertes silencieuses ressemblent à de la diligence.
L’asymétrie s’accentue lorsque le même groupe vend l’alerte et la pièce de remplacement. Personne n’a besoin d’agir de mauvaise foi pour que le résultat dérive ; un seuil fixé de façon légèrement prudente, encore et encore, produit un taux de dépose qui convient mieux à une partie qu’à l’autre. Le contrepoids est la mesure : un taux de NFF suivi sur les déposes déclenchées par le système, comparé au taux de NFF sur les déposes déclenchées de l’ancienne manière, et un temps moyen entre déposes non programmées surveillé sur la même période. Si un système prédictif fonctionne, les déposes non programmées devraient diminuer et la part des alertes confirmées devrait augmenter. Si les déposes augmentent et les découvertes non, le système vend des pièces.
Un contrat basé sur la disponibilité peut inverser l’incitation, car le fournisseur porte alors le coût à la fois de la panne et de la dépose inutile. Lorsqu’il est écrit de cette manière, cet alignement vaut plus que n’importe quel chiffre de précision.
Le faire tourner en mode fantôme avant de lui confier l’atelier
La manière défendable d’introduire un système prédictif est de le laisser parler dans le vide suffisamment longtemps pour être compté. Dans un déploiement en mode fantôme, les alertes sont enregistrées, horodatées et clôturées au regard de ce qui s’est réellement passé, mais elles ne déclenchent pas d’action de maintenance. Cela coûte un abonnement et une certaine attention d’ingénierie, et cela produit les deux chiffres qu’aucune démonstration ne peut fournir : combien d’alertes par aéronef par mois, et quelle part d’entre elles correspondaient à une découverte.
Quelques points de conception justifient le délai de la phase fantôme. Fixez les seuils avant le début de la période et résistez à la tentation de les ajuster en cours de route, sinon le résultat est une autre démonstration ajustée rétrospectivement. Incluez les avions les moins représentatifs — les cellules les plus anciennes, le standard moteur différent, ceux basés là où l’environnement est difficile — car c’est l’hétérogénéité qui met en échec les modèles à l’échelle de la flotte. Enregistrez aussi les non-alertes, afin qu’une panne sur laquelle le système est resté silencieux soit comptée plutôt qu’oubliée. Et convenez à l’avance du chiffre qui ferait du déploiement un échec, car un seuil défini a posteriori est toujours atteint.
Les exploitants qui comparent leurs expériences sur le comportement réel de ces déploiements en service trouveront plus de franchise dans une discussion entre pairs que dans une étude de cas de fournisseur ; les forums FL330 accueillent ce type d’échanges entre le personnel de maintenance et d’ingénierie.
Que demander avant de quitter le stand
| Question | Réponse qui ne signifie rien | Réponse qui mérite d’être creusée |
|---|---|---|
| Combien d’alertes le système a-t-il émises l’année dernière sur votre base de clients ? | Notre taux de détection est supérieur à 90 % | Un nombre, une taille de flotte et une période, avec la part de découvertes confirmées |
| Quel est le délai entre l’alerte et la panne ? | Des semaines à l’avance | Une distribution, y compris les délais très courts et les alertes très précoces |
| Une autorité a-t-elle accepté cette surveillance comme crédit de programme ? | Nous travaillons avec les régulateurs | Un cas précis, ou une déclaration claire qu’il s’agit uniquement de conseils |
| Que deviennent nos données si nous partons ? | Vos données vous appartiennent | Un format, un délai et un engagement de suppression dans la clause de sortie |
| Qui supporte le coût d’une dépose non confirmée ? | Les fausses alertes sont rares | Un mécanisme de partage des coûts, ou un contrat de disponibilité |
| Pouvons-nous voir la logique d’alerte ? | Elle est propriétaire | Caractéristiques documentées, seuils et journal des modifications |
Rien de cela ne s’oppose à la maintenance prédictive. La surveillance d’état a remplacé les intervalles fixes pour une grande partie du contenu d’un moteur depuis longtemps, et cela fonctionne. Il montre seulement que ce que l’on achète n’est pas la détection — la détection est la partie facile et elle a été démontrée il y a des années. Ce que l’on achète, c’est un taux de fausses alertes que l’atelier peut absorber, un délai d’alerte qui s’adapte au réseau, une position définie dans un programme approuvé, et un ensemble de droits sur les données qui survivent à la fin du contrat. Tous quatre relèvent du contrat, et aucun d’eux n’est visible sur la diapositive avec le marqueur rouge.


Laisser un commentaire
Vous devez vous connecter pour publier un commentaire.